01
灵活定义选项
适配工单、对话、新闻与表单等业务输入。
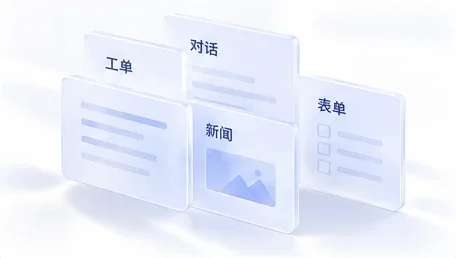
通用大模型先写出一段文字,再从文字里解析答案,又慢,又不稳定。FastDecide 把开源基座改造成判断器:读完输入后,直接在每个选项的位置计算概率,给出可校准的结果,并驱动后续业务流程。
根据业务目标设定可选项,支持多标签与层级分类。
模型直接计算各选项概率,输出可校准的判断结果。
将结果接入业务系统,自动完成分派、标记或处置。
输入业务内容与候选选项,直接返回概率,为自动化流程提供清晰依据。
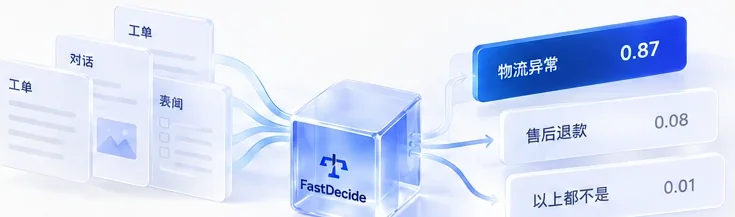
适配工单、对话、新闻与表单等业务输入。
无需逐字生成,直接返回各选项概率。
高把握结果自动处理,边界样本转人工复核。
FastDecide 提供 HTTP 接口,传入内容和选项、返回概率,可以快速集成到你的业务系统中,让判断结果直接触发后续流程。
{ "state": "订单显示已签收", "question": "这张工单交给哪个组?", "options": ["物流异常", "售后退款"]}
{ "物流异常": 0.87, "售后退款": 0.08, "以上都不是": 0.01}
CLUE 与 MASSIVE 中文数据集 · 每项 300 题
每项取前 300 题,双方题目完全相同。“零样本”表示这类任务 FastDecide 在训练中从未见过。
| 任务 | 类型 | FastDecide 1.7B |
DeepSeek | ECE | |
|---|---|---|---|---|---|
| 8 项平均准确率 | 78.4 | 78.3 |
FastDecide 1.7B
DeepSeek(官方接口)
横轴从 50% 起
|
||
| 零样本 4 项平均 | 78.5 | 83.7 | |||
语义匹配、新闻分类、意图识别、推理判断这几类,FastDecide 领先 3 到 12 个百分点。这些任务也最接近工单分派和内容打标。
单次 25.6 ms,p95 为 25.8 ms,耗时稳定。同样的题目,调用大模型接口约需 770 ms,还要加上网络往返。
指代消解、阅读理解这类依赖常识的题目,以及 119 类的长尾分类,1.7B 仍落后 9 到 12 个百分点。更大的 8B 版本正在训练,目标就是补上这一块。
面向客服运营、内容处理与智能体流程,提供可集成的决策能力。
支持私有化交付与业务适配,推理无需调用外部模型接口。
适配用的业务样本可以先脱敏,模型训练和运行都在你们内部的环境中进行,确保数据安全与合规可控。
用你的标签体系和历史数据继续训练,并重新校准概率,让模型更贴合你的业务语义和决策习惯。
提供 HTTP 接口,传入内容和选项,返回概率。现有系统改动很小,可快速集成到业务流程中。
实际性能以目标硬件环境中的验证结果为准。
先用真实样本验证价值,再推进适配、部署与持续优化。
明确判断任务,准备 100–300 条脱敏样本及对应答案。
约 1 天
对比准确率、响应时间与硬件需求,形成场景测试结果。
3–5 个工作日
结合业务数据适配模型,完成环境部署与系统接入。
1–3 周
随业务变化更新样本,持续复测效果与校准概率。
按年
我们基于真实业务问题,持续推进模型能力建设,让决策模型在更多场景中产生可验证的价值。
8 项中文任务平均 78.4%,与 DeepSeek 同题对比持平,单次 25.6 ms。
中文判断任务与真实事件预测数据联合训练,重点提升常识类题目。
用已结算的预测市场问题训练和校准,评估对未来事件给出概率的能力。
告诉我们你的应用场景、候选类别与调用规模。
用真实数据验证效果,为后续部署提供依据。